
Les failles XSS (Cross-Site Scripting) font partie des vulnérabilités historiques des applications web. Selon le contexte, une faille XSS peut mener à un détournement de session, un vol d’identifiants, une prise de contrôle de compte, une exposition de données sensibles, voire la compromission d’interfaces d’administration.
Dans cet article, nous présentons le principe et le fonctionnement des failles XSS. Nous détaillons également les différents types d’attaques XSS, les contextes d’injection, les mécanismes propres au DOM, les scénarios d’exploitation, ainsi qu’une méthodologie de recherche utilisable lors d’un pentest. Enfin, nous présentons les mécanismes de prévention et de défense en profondeur pour prévenir les failles XSS.
Guide complet sur les failles XSS (Cross-Site Scripting)
- Qu’est-ce qu’une faille XSS (Cross-Site Scripting) ?
- Comment fonctionne une XSS ?
- Comprendre les contextes d’injection XSS
- Injection dans le contenu HTML
- Injection dans un attribut HTML
- Attributs dangereux et séparation entre données et code
- Injection dans une chaîne JavaScript
- Guillemets simples, doubles et template literals
- Données JSON embarquées dans une page
- Injection dans une URL
- Injection dans un contexte CSS
- SVG, MathML et contenus HTML riches
- Injections à travers plusieurs contextes successifs
- Quels sont les types d'attaques XSS ?
- DOM-Based XSS : comprendre les sources et les sinks
- Mutation XSS et complexité du parsing HTML
- Comment les attaquants exploitent les failles XSS ?
- Méthodologie de détection de failles XSS lors d'un pentest
- Comment prévenir les vulnérabilités XSS ?
- Encoder au moment de la sortie et selon le contexte
- Privilégier les safe sinks
- Sanitiser lorsque du HTML doit réellement être accepté
- Valider les entrées lorsque le format est connu
- Éviter les blocklists de payloads
- Conserver les protections automatiques des frameworks
- Content Security Policy comme défense en profondeur
- Trusted Types pour réduire les DOM XSS
- HttpOnly et réduction de l’impact
- SameSite et périmètre réel de la protection
- Isoler les interfaces et origines sensibles
- Maintenir les bibliothèques de rendu et de sanitisation
- Conclusion
Qu’est-ce qu’une faille XSS (Cross-Site Scripting) ?
Une XSS est une vulnérabilité d’injection côté client dans laquelle une donnée contrôlable par un attaquant est interprétée par le navigateur comme du contenu actif alors qu’elle aurait dû rester une simple donnée.
Contrairement à une injection SQL, dont l’objectif est généralement d’altérer la requête envoyée à un moteur de base de données, la XSS vise principalement le navigateur. Celui-ci constitue néanmoins un environnement particulièrement sensible : il héberge l’interface applicative, les données affichées, les mécanismes de session et une partie de la logique permettant d’interagir avec le backend.
Lorsqu’un script injecté s’exécute dans l’origine de l’application vulnérable, il est soumis aux mêmes règles de sécurité du navigateur que le JavaScript légitime de cette origine. Il peut donc, selon l’architecture, lire le DOM, accéder aux données JavaScript disponibles, interagir avec certains stockages côté client et envoyer des requêtes vers les ressources accessibles depuis cette session.
Un exemple classique est le suivant :
<script>alert(1)</script>Ce payload est utile pour confirmer visuellement la possibilité d’exécuter du JavaScript, mais elle ne représente pas l’impact réel. Une évaluation sérieuse cherche ensuite à comprendre ce que le navigateur compromis peut faire dans le contexte concret de la victime.
Comment fonctionne une XSS ?
Donnée contrôlable, interprétation et contexte de sortie
Une XSS apparaît généralement lorsque trois conditions se rencontrent : un attaquant contrôle une donnée, cette donnée atteint un point de rendu ou un sink sensible, et le traitement appliqué n’est pas adapté au contexte d’interprétation.
Prenons par exemple une fonctionnalité de recherche simplifiée :
<p>Résultats pour : <?php echo $_GET['q']; ?></p>Avec la requête :
/search?q=ordinateurle navigateur reçoit par exemple :
<p>Résultats pour : ordinateur</p>Si la valeur de q contient du balisage et qu’aucun encodage de sortie n’est appliqué, le navigateur peut construire de nouveaux éléments au lieu d’afficher une chaîne de caractères. Le problème n’est donc pas que la valeur ait été « mauvaise » à son entrée dans l’application. Le problème apparaît lorsqu’elle est utilisée dans un contexte où certains caractères modifient la syntaxe attendue.
Ce principe est fondamental : une donnée n’est pas intrinsèquement sûre parce qu’elle provient d’une base de données, d’une API interne ou d’un utilisateur déjà authentifié. La sécurité doit être évaluée au moment de l’utilisation.
Rôle du navigateur et de l’origine
Le navigateur applique notamment la Same-Origin Policy pour empêcher une page d’accéder arbitrairement aux données d’un autre site. Une XSS détourne ce modèle de confiance : le code malveillant n’est pas exécuté depuis un site externe, mais directement dans l’origine vulnérable.
Cela ne signifie pas qu’il obtient un accès illimité au poste de travail. Le sandboxing du navigateur, les permissions, CSP (Content Security Policy) et les autres mécanismes de sécurité continuent de s’appliquer. En revanche, pour l’application concernée, le script injecté se trouve dans une position très favorable. Il peut souvent appeler les mêmes API que l’interface légitime et agir avec les privilèges de l’utilisateur qui a déclenché la charge.
C’est également la raison pour laquelle les protections CSRF deviennent souvent insuffisantes lorsqu’une XSS est présente. Elles sont conçues pour empêcher un site tiers de déclencher des actions, pas pour faire face à du JavaScript exécuté au sein même de l’origine de confiance.
Comprendre les contextes d’injection XSS
L’identification du contexte d’injection est l’étape la plus importante avant de construire un payload. Le navigateur n’interprète pas de la même manière une donnée placée dans le corps HTML, dans un attribut, dans une chaîne JavaScript, dans une URL ou dans un fragment CSS.
Les caractères ayant une signification syntaxique et les mécanismes de protection nécessaires diffèrent donc selon la position.
Injection dans le contenu HTML
Le cas le plus direct est celui d’une donnée insérée entre deux balises :
<div class="result">
    USER_INPUT
</div>
Une implémentation vulnérable peut être :
<div class="result">
    <?php echo $_GET['search']; ?>
</div>
Si l’entrée suivante est conservée telle quelle :
<img src=x onerror=alert(1)>le navigateur crée un véritable élément HTML et interprète son gestionnaire d’évènement. L’injection d’une balise <script> n’est donc pas nécessaire.
Lorsque le besoin consiste simplement à afficher du texte, la valeur doit être encodée pour le contexte HTML.
En PHP, une implémentation peut par exemple s’appuyer sur :
echo htmlspecialchars(
    $_GET['search'],
    ENT_QUOTES | ENT_SUBSTITUTE,
    'UTF-8'
);
La chaîne est alors rendue comme du texte, sans modifier la structure du document. Cette opération doit être effectuée au moment du rendu ; il est généralement préférable de conserver la donnée originale en stockage plutôt que d’enregistrer une version déjà échappée pour un contexte particulier.
Injection dans un attribut HTML
Considérons maintenant :
<input type="text" value="USER_INPUT">La donnée est entourée de guillemets doubles. Si le guillemet n’est pas correctement encodé, une valeur contrôlée peut fermer l’attribut et en introduire de nouveaux.
Une entrée telle que :
" autofocus onfocus="alert(1)peut transformer une structure vulnérable en :
<input type="text" value="" autofocus onfocus="alert(1)">Le détail important est ici la rupture du délimiteur. Un payload destiné au corps HTML n’est donc pas nécessairement adapté à un attribut.
Il est également préférable de toujours entourer les valeurs dynamiques par des guillemets. Les attributs non délimités offrent au parseur davantage de possibilités d’interprétation et compliquent inutilement la protection.
Attributs dangereux et séparation entre données et code
Tous les attributs ne présentent pas le même risque. Une donnée textuelle placée dans title n’est pas équivalente à une donnée injectée dans onclick :
<button onclick="showProfile('USER_INPUT')">Voir le profil</button>Dans cet exemple, l’application place volontairement une donnée au milieu d’un contexte JavaScript. Même un système d’encodage complexe devient fragile, car plusieurs syntaxes s’imbriquent.
Une conception plus sûre consiste à séparer le comportement et les données :
<button id="profileButton">Voir le profil</button>puis à associer l’évènement depuis un script statique :
document
  .getElementById('profileButton')
  .addEventListener('click', showProfile);
Le principe général est simple : lorsqu’une architecture permet d’éviter d’insérer une valeur non fiable directement dans du code, cette solution est généralement préférable à une tentative de filtrage.
Injection dans une chaîne JavaScript
Une donnée peut être directement introduite dans un bloc JavaScript :
<script>
const username = 'USER_INPUT';
</script>
Le parseur pertinent n’est plus uniquement le parseur HTML. Le navigateur doit également interpréter la syntaxe JavaScript. Une protection conçue exclusivement pour le corps HTML n’est donc pas suffisante.
Il faut éviter autant que possible de construire du code JavaScript par concaténation avec des données non fiables. Lorsque le serveur doit transmettre des valeurs au client, celles-ci doivent être sérialisées avec un mécanisme conçu pour produire une représentation de données valide et intégré à une structure qui ne permet pas de sortir du contexte prévu.
En PHP, une approche est par exemple d’utiliser json_encode() avec des options adaptées au contexte HTML plutôt que de construire manuellement une chaîne :
<script>
const username = <?php echo json_encode(
    $username,
    JSON_HEX_TAG | JSON_HEX_AMP | JSON_HEX_APOS | JSON_HEX_QUOT
); ?>;
</script>
Dans une architecture moderne, il est souvent encore préférable de charger les données via une API JSON ou de les placer dans un mécanisme de données dédié, puis de conserver le code JavaScript statique.
Guillemets simples, doubles et template literals
Les constructions suivantes utilisent des grammaires différentes :
const value1 = 'USER_INPUT';
const value2 = "USER_INPUT";
const value3 = `USER_INPUT`;
Les template literals (strings) peuvent notamment contenir des expressions ${...}. Un filtre pensé uniquement pour neutraliser l’apostrophe ne protège donc pas une valeur réutilisée avec des guillemets doubles ou des backticks.
Lors d’un audit, le choix du délimiteur fait partie du contexte à identifier. Il ne faut jamais déduire la sécurité d’un champ d’après le comportement observé dans une autre restitution de la même donnée.
Données JSON embarquées dans une page
De nombreuses applications insèrent un état initial dans un élément <script> :
<script>
window.initialData = {
  "username": "USER_INPUT"
};
</script>
Le fait que la structure ressemble à du JSON ne suffit pas à la rendre sûre. Il faut distinguer une véritable réponse application/json d’un fragment de données sérialisées placé au milieu d’un document HTML et d’un élément script.
Dans ce second cas, les règles du document englobant restent importantes. Une sérialisation incorrecte peut notamment laisser apparaître des séquences qui modifient la structure HTML avant même que le moteur JavaScript n’interprète la valeur.
Injection dans une URL
Une application peut construire un lien à partir d’une valeur contrôlable :
<a href="USER_INPUT">Continuer</a>Deux problèmes différents doivent être traités. L’encodage empêche la donnée de casser la syntaxe de l’attribut ; la validation vérifie que l’URL elle-même correspond à ce que l’application accepte.
Si la fonctionnalité doit uniquement générer des liens HTTPS vers une liste de domaines approuvés, la politique doit être explicitement vérifiée. Une chaîne peut être parfaitement encodée du point de vue HTML tout en restant une destination interdite fonctionnellement.
Cette distinction entre encodage et validation est essentielle pour les liens dynamiques, les redirections, les callbacks et certaines APIs JavaScript manipulant des URL.
Injection dans un contexte CSS
Les injections CSS sont moins couramment exploitées comme XSS directe dans les navigateurs modernes que certaines techniques historiques. Elles restent néanmoins importantes pour comprendre le raisonnement contextuel.
Considérons :
<style>
.profile {
  background-image: url('USER_INPUT');
}
</style>
La donnée est ici interprétée dans une syntaxe CSS, elle-même intégrée à un document HTML. Une validation stricte de la valeur attendue est généralement préférable à l’acceptation d’un fragment CSS arbitraire. Si l’utilisateur ne doit choisir qu’une couleur, l’application peut par exemple limiter la valeur à un format de couleur attendu au lieu d’accepter une propriété complète.
SVG, MathML et contenus HTML riches
Une application qui autorise du HTML riche doit également tenir compte des namespaces tels que SVG ou MathML et des particularités de parsing associées. La difficulté ne vient pas seulement d’une liste de balises dangereuses, mais des interactions entre éléments, attributs et transformations du DOM.
C’est l’une des raisons pour lesquelles un sanitizer HTML robuste ne doit pas être remplacé par quelques expressions régulières. Les bibliothèques spécialisées s’appuient sur une compréhension structurée du document et sur des politiques précises d’éléments et d’attributs autorisés.
Injections à travers plusieurs contextes successifs
Une donnée peut être sûre dans un premier rendu puis devenir dangereuse lorsqu’elle est réutilisée.
Supposons que le serveur produise :
<div id="data">
<img src=x onerror=alert(1)>
</div>Le contenu est inoffensif à ce stade : il est affiché comme du texte. Un script peut toutefois le relire et le réinjecter :
const value = document
  .getElementById('data')
  .textContent;

preview.innerHTML = value;
textContent restitue les caractères logiques, puis innerHTML demande au navigateur de les interpréter comme du HTML. Le problème apparaît donc au second sink.
Ce scénario illustre un principe général : une donnée ne devient pas « définitivement sûre » parce qu’elle a été encodée une fois. La protection doit être adaptée à chaque utilisation sensible.
Quels sont les types d’attaques XSS ?
Les XSS sont souvent présentées en trois grandes catégories : XSS reflétées (reflected XSS), XSS stockées (stored XSS) et XSS basées sur le DOM (DOM-Based XSS). Cette classification est utile, mais elle ne décrit pas exactement la même dimension dans tous les cas. Les XSS reflétées et stockées indiquent surtout comment la donnée atteint la victime, tandis que les XSS DOM-Based décrivent la localisation du traitement vulnérable côté client.
Blind XSS et Self-XSS sont mieux comprises comme des scénarios particuliers plutôt que comme des catégories strictement équivalentes.
Attaques XSS reflétées (reflected XSS)
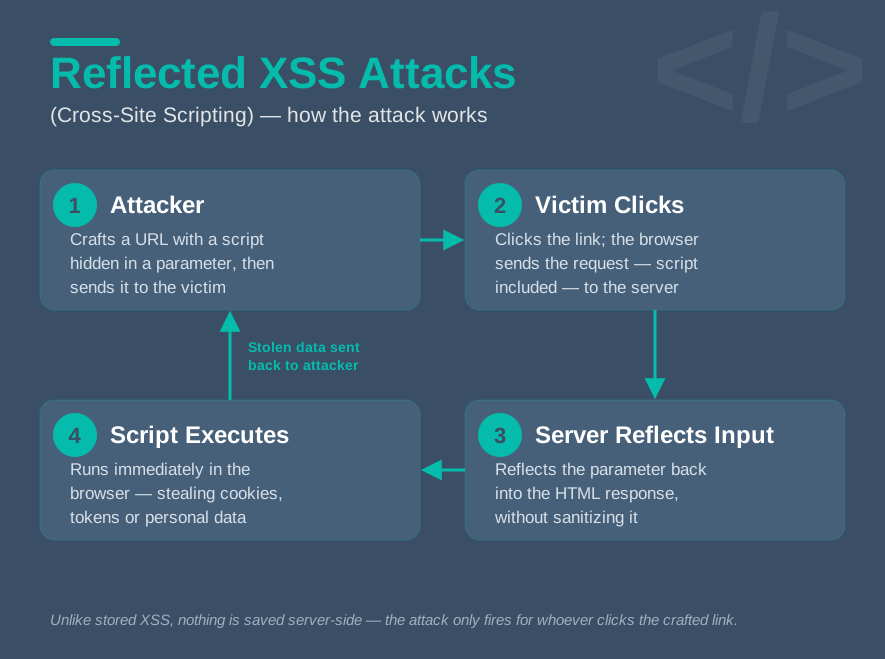
Une XSS reflétée apparaît lorsqu’une donnée provenant de la requête courante est immédiatement réintroduite dans la réponse ou dans le DOM de manière dangereuse.
Une fonctionnalité de recherche peut par exemple contenir :
echo $_GET['search'];Le payload n’est pas nécessairement stocké. L’attaquant doit généralement amener la victime à charger une requête construite spécialement, par exemple via un lien ou une redirection.
La nécessité d’une interaction ne signifie pas automatiquement que la sévérité est faible. Si la page est consultée par un utilisateur authentifié et expose des actions sensibles, l’exécution du JavaScript peut fournir un accès important à sa session.
Attaques XSS stockées (Stored XSS)
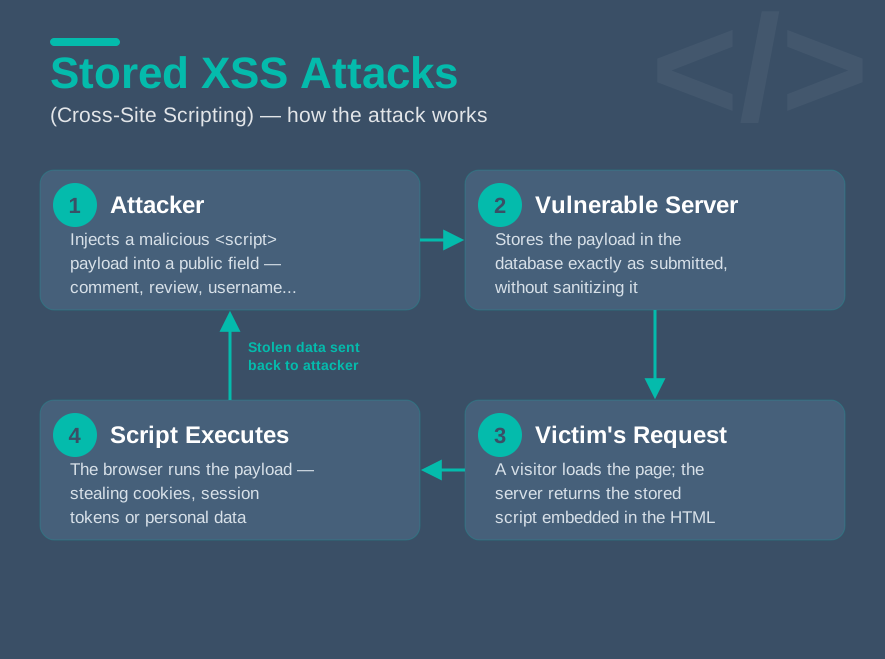
Une XSS stockée apparaît lorsqu’une donnée contrôlée est conservée puis restituée ultérieurement sans protection adaptée. Elle peut être stockée dans une base de données, un fichier, un système de logs ou tout autre mécanisme persistant.
Les champs de profil, commentaires, tickets de support, outils collaboratifs, systèmes de messagerie et contenus éditoriaux sont des points d’entrée classiques. Le danger vient du fait que la charge devient une partie du contenu de l’application et peut être exécutée automatiquement à chaque consultation.
Une XSS stockée est particulièrement critique lorsque la donnée est affichée à des opérateurs privilégiés ou à de nombreux utilisateurs. Le même payload peut alors toucher plusieurs victimes sans nécessiter un lien spécifique pour chacune d’elles.
XSS basées sur le DOM (DOM-Based XSS)
Une DOM-Based XSS apparaît lorsque la vulnérabilité se situe dans le code exécuté côté navigateur. Le serveur peut ne jamais recevoir ou refléter le payload complet.
Par exemple :
document
  .getElementById('output')
  .innerHTML = location.hash;
Le fragment situé après # dans une URL n’est normalement pas envoyé au serveur. Le JavaScript de la page peut cependant le lire puis l’insérer dans le DOM. Si le sink interprète la valeur comme du HTML, une injection peut donc se produire entièrement côté client.
Blind XSS
Une Blind XSS correspond généralement à une injection qui s’exécute ultérieurement dans un contexte que l’attaquant ne peut pas observer directement. Il s’agit fréquemment d’une Stored XSS déclenchée dans une interface interne.
Un formulaire public peut par exemple enregistrer le nom d’une société, un objet de ticket ou un message. L’utilisateur ne voit ensuite jamais ces données, mais celles-ci peuvent être affichées dans un CRM ou un back-office utilisé par le support.
Lors d’un pentest, un mécanisme de callback contrôlé peut permettre de confirmer qu’une valeur injectée a été interprétée dans une interface non accessible à l’auditeur. Ce type de vulnérabilité est particulièrement intéressant car la victime peut disposer de privilèges élevés.
Self-XSS
Le terme Self-XSS désigne des scénarios dans lesquels un utilisateur doit lui-même exécuter le code, par exemple en le collant dans la console du navigateur après une manipulation sociale.
Ce cas ne doit pas être confondu avec une vulnérabilité XSS classique permettant de provoquer automatiquement l’exécution du code chez une autre victime. Le risque repose essentiellement sur le social engineering.
Il peut toutefois devenir pertinent lorsqu’une autre faiblesse transforme cette action manuelle en chaîne d’exploitation automatisable. La distinction doit donc être expliquée plutôt que simplement classée comme une XSS de même nature que les précédentes.
DOM-Based XSS : comprendre les sources et les sinks
Les applications modernes réalisent une grande partie de leur logique dans le navigateur. Pour analyser une DOM XSS, il faut suivre le chemin parcouru par une donnée entre une source potentiellement contrôlée et un sink capable de l’interpréter de manière dangereuse.
Les sources contrôlables
Une source est un endroit depuis lequel le JavaScript récupère une valeur. Les URL constituent une famille importante de sources via location.search, location.hash, location.href ou document.URL. document.referrer, window.name et les messages reçus via postMessage peuvent également être intéressants selon le modèle de confiance de l’application.
Le stockage côté client n’est pas automatiquement une source hostile, mais une valeur située dans localStorage, sessionStorage ou IndexedDB devient pertinente si un attaquant possède un moyen de l’influencer. Il en va de même pour des données récupérées via une API : la question n’est pas seulement « d’où viennent-elles ? », mais « qui peut contrôler leur contenu avant qu’elles atteignent le navigateur ? ».
Les sinks HTML dangereux
Un sink est une opération dans laquelle la donnée est utilisée. Des APIs telles que innerHTML, outerHTML, insertAdjacentHTML() ou document.write() demandent au navigateur d’interpréter une chaîne comme du HTML.
Par exemple :
element.innerHTML = userInput;est beaucoup plus risqué que :
element.textContent = userInput;lorsque le besoin fonctionnel consiste uniquement à afficher du texte. La différence ne vient pas de la donnée elle-même, mais du comportement demandé au navigateur.
Les sinks exécutant ou construisant du code
Les fonctions qui évaluent une chaîne comme du JavaScript sont encore plus sensibles. eval() et new Function() constituent des exemples évidents. Certaines formes de setTimeout() ou setInterval() peuvent également évaluer une chaîne lorsqu’elles ne reçoivent pas une fonction.
L’objectif de remédiation doit généralement être de supprimer l’évaluation dynamique de données non fiables. Chercher à filtrer toutes les syntaxes JavaScript possibles est un modèle beaucoup plus fragile.
Suivre le flux entre source et sink
Considérons :
const fragment = location.hash.substring(1);
const decoded = decodeURIComponent(fragment);
document.getElementById('result').innerHTML = decoded;
location.hash constitue la source. substring() modifie la chaîne, decodeURIComponent() la transforme à nouveau et innerHTML constitue le sink final.
Une analyse correcte suit la valeur jusqu’au moment où elle est utilisée. Dans une application réelle, plusieurs fonctions, composants et bibliothèques peuvent intervenir entre la source et le sink. C’est précisément cette distance qui rend certaines DOM XSS difficiles à identifier avec un simple scanner HTTP.
postMessage et confiance entre origines
postMessage est largement utilisé dans les applications comprenant des iframes, des composants embarqués ou des flux SSO. Un traitement dangereux peut ressembler à :
window.addEventListener('message', event => {
  result.innerHTML = event.data;
});
Deux dimensions doivent être analysées : qui peut envoyer le message, et comment event.data est utilisé.
Une implémentation plus robuste vérifie l’origine lorsque le modèle de confiance l’exige et utilise un sink textuel si le contenu n’a pas besoin d’être interprété comme HTML :
window.addEventListener('message', event => {
  if (event.origin !== 'https://trusted.example') {
    return;
  }

  result.textContent = event.data;
});
Le contrôle d’event.origin et le choix d’un sink sûr répondent à deux risques différents. L’un ne remplace pas l’autre.
Décodages multiples et représentations successives
Une valeur peut être encodée, décodée puis réencodée plusieurs fois. Dans ce cas, un mécanisme de sécurité situé en amont peut analyser une représentation différente de celle qui atteint réellement le sink.
Le double encodage n’est pas automatiquement un contournement. Il rappelle simplement qu’un audit doit observer la représentation exacte de la donnée à chaque étape. La valeur qui compte est celle finalement consommée par le parseur ou le sink sensible.
DOM Clobbering et chaînes d’exploitation
Le DOM Clobbering exploite certains comportements du navigateur dans lesquels des éléments possédant des attributs id ou name peuvent influencer des propriétés accessibles depuis window ou document.
Ce mécanisme n’est pas une XSS à lui seul, mais il peut devenir une brique d’une chaîne. Un script peut par exemple supposer qu’une propriété globale contient une valeur de configuration sûre alors qu’un élément HTML injecté modifie ce que le code récupère.
La présence de DOM Clobbering dans ce dossier permet surtout de rappeler qu’une exécution de JavaScript peut provenir d’une interaction entre plusieurs primitives et pas uniquement d’une insertion directe de <script>.
Mutation XSS et complexité du parsing HTML
Pourquoi la sanitisation HTML est complexe
Lorsqu’une application souhaite autoriser du HTML riche, l’encodage complet n’est plus compatible avec la fonctionnalité : il transformerait aussi les balises légitimes en texte. Il faut alors autoriser certaines structures et en éliminer d’autres.
Le problème est que le HTML n’est pas une chaîne interprétée de manière triviale. Le navigateur parse le document, corrige certaines structures, applique des règles différentes selon les namespaces et peut produire un DOM qui diffère de la représentation textuelle initiale.
Cette complexité rend les sanitizers artisanaux particulièrement risqués. Une expression régulière qui supprime <script> ne comprend ni la structure du document ni les multiples manières d’obtenir un comportement actif.
mXSS : quand le DOM évolue après la sanitisation
Les mutation XSS, ou mXSS, exploitent des différences entre la représentation analysée par un mécanisme de sanitisation et celle obtenue après une nouvelle phase de parsing, de sérialisation ou de mutation du DOM.
L’idée importante n’est pas de mémoriser un payload particulier. Il faut comprendre qu’un contenu peut être considéré comme sûr dans un état puis devenir interprétable différemment après une transformation du navigateur ou d’une bibliothèque.
Cela justifie l’utilisation de bibliothèques spécialisées et activement maintenues, ainsi qu’une attention particulière au code exécuté après la sanitisation. Une valeur assainie puis concaténée avec une nouvelle donnée non fiable peut évidemment redevenir dangereuse.
Comment les attaquants exploitent les failles XSS ?
Une boîte de dialogue alert() confirme la présence d’une faille XSS. L’impact réel doit être évalué à partir du navigateur compromis, de la session de la victime et des fonctionnalités auxquelles elle a accès.
Agir dans la session authentifiée de la victime
L’un des scénarios les plus importants consiste à utiliser directement la session de la victime. Historiquement, les démonstrations se concentraient sur le vol de cookies via document.cookie. L’attribut HttpOnly empêche JavaScript de lire directement un cookie concerné, mais il ne neutralise pas la XSS.
Un script exécuté dans l’application peut souvent envoyer une requête vers un endpoint de la même origine :
fetch('/api/account/details', {
  credentials: 'include'
});
Lorsque la session repose sur des cookies applicables à cette requête, le navigateur peut les joindre sans que le script ait besoin de connaître leur valeur.
L’attaquant peut donc parfois consulter des données ou déclencher des actions depuis le navigateur authentifié sans voler le token de session.
Compromission d’une interface d’administration
La sévérité augmente fortement lorsqu’une injection peut être déclenchée par un administrateur. Un cas classique consiste à injecter une donnée dans un ticket, un message ou une fiche client qui sera ultérieurement affiché dans un back-office.
Le JavaScript s’exécute alors avec le contexte de l’utilisateur privilégié. Selon les fonctionnalités exposées dans l’interface, il peut potentiellement accéder à des données supplémentaires, créer un compte, modifier des permissions ou appeler des endpoints d’administration.
L’impact ne doit pas être extrapolé sans preuve. Lors d’un pentest, il est préférable de démontrer une action contrôlée sur un objet ou un compte de test plutôt que de réaliser des opérations destructrices.
Vol de données accessibles côté client
Une XSS peut lire les données présentes dans le DOM et, selon les mécanismes de stockage, certaines valeurs conservées dans localStorage, sessionStorage ou IndexedDB. Elle peut également accéder aux objets JavaScript exposés dans la page.
Cette capacité devient particulièrement sensible lorsqu’une application stocke un token d’accès dans un espace accessible au JavaScript de l’origine. Contrairement à un cookie HttpOnly, ce token peut alors être lu directement par le script injecté.
Le risque doit cependant être évalué en fonction des scopes, de la durée de validité, de la rotation, de la révocation et des restrictions côté serveur. Le simple fait qu’un token soit un JWT n’est pas en soi le problème principal.
Phishing dans l’origine légitime
Un script injecté peut modifier l’interface affichée à l’utilisateur : ajouter un formulaire, masquer un message, remplacer une zone de contenu ou afficher une demande de réauthentification.
Ce scénario est particulièrement convaincant parce que l’utilisateur reste sur le domaine légitime. Les signaux habituels du phishing, comme un nom de domaine inconnu, disparaissent en partie. La XSS transforme donc l’application compromise en support d’ingénierie sociale.
Lors d’un audit, une preuve visuelle non destructive peut suffire à démontrer ce risque, sans collecter de véritables identifiants.
Keylogging et observation des interactions
Le JavaScript peut enregistrer des listeners sur certains évènements de la page et observer les interactions avec l’interface. Techniquement, cela peut permettre de capturer des données saisies dans des champs accessibles au même contexte.
La portée dépend du contenu réellement traité par la page. Dans un back-office sensible, des informations d’authentification, des données métier ou des commandes privilégiées peuvent être concernées. L’évaluation doit rester fondée sur les fonctionnalités présentes plutôt que sur une hypothèse générique.
XSS et protections CSRF
Une XSS rend souvent les protections CSRF largement insuffisantes parce que le code malveillant s’exécute déjà dans l’origine de confiance. Il faut néanmoins être précis : le navigateur n’ajoute pas automatiquement un token CSRF arbitraire ou un header d’authentification personnalisé à toute requête.
Le script injecté peut en revanche reproduire le fonctionnement légitime de l’application : lire un token présent dans le DOM lorsqu’il est accessible, appeler un endpoint qui le fournit, ou déclencher la même fonction JavaScript que l’interface normale.
La XSS ne « casse » donc pas cryptographiquement le mécanisme CSRF ; elle contourne son hypothèse de sécurité principale, selon laquelle le code exécuté dans l’origine applicative est digne de confiance.
XSS et tokens JWT
Dans une SPA (Single Page Application), un token JWT peut être utilisé comme bearer token pour appeler une API. Si ce token est stocké dans localStorage ou un autre espace accessible à JavaScript, une XSS peut potentiellement l’extraire puis le réutiliser hors du navigateur, selon les contrôles côté serveur.
Si l’authentification repose au contraire sur un cookie HttpOnly, le vol direct du secret peut être empêché, mais le script peut encore agir dans la session tant qu’il s’exécute dans le navigateur.
L’évaluation doit donc distinguer vol du secret d’authentification et usage de la session de la victime. Ces deux scénarios n’ont pas les mêmes conséquences en termes de persistance et de détection.
Chaînage de XSS avec d’autres vulnérabilités
Une XSS peut devenir une étape dans une chaîne d’attaque plus large. Elle peut par exemple permettre d’atteindre une fonctionnalité interne réservée à un administrateur, de récupérer une donnée nécessaire à une autre attaque ou de déclencher une action qui expose une nouvelle surface.
Le raisonnement doit rester concret : il ne suffit pas d’énumérer toutes les vulnérabilités imaginables. Une chaîne pertinente est celle dont les prérequis sont réellement réunis dans l’application testée.
Méthodologie de détection de failles XSS lors d’un pentest
La recherche de XSS gagne énormément en efficacité lorsqu’elle est menée comme une analyse de données, de contextes et de sinks, plutôt que comme l’envoi aléatoire d’une longue liste de payloads.
Cartographier les entrées contrôlables
L’auditeur commence par identifier les données qu’un attaquant peut influencer : paramètres GET et POST, champs de formulaires, profils, commentaires, tickets, messages, noms de fichiers, paramètres de redirection, fragments d’URL, données envoyées à des API, headers HTTP ou valeurs provenant d’intégrations tierces.
Il faut également penser aux données qui ne sont pas immédiatement affichées. Un champ « Société » saisi dans un portail public peut être réutilisé dans un CRM, une facture HTML, un email ou un back-office. Chaque restitution représente un contexte de sécurité différent.
Utiliser des marqueurs uniques
Avant d’envoyer un payload actif, un marqueur reconnaissable est souvent plus utile :
XSS-HACKAGORA-84721L’objectif est de retrouver la valeur dans les réponses et dans le DOM, de déterminer si elle est stockée, si elle apparaît à plusieurs endroits et quelles transformations elle subit.
Pour les tests persistants ou aveugles, il est utile d’utiliser un identifiant différent par champ :
XSS-NAME-84721
XSS-COMPANY-84722
XSS-SUBJECT-84723
XSS-MESSAGE-84724
Ainsi, un callback ou une restitution observée plus tard peut être relié précisément au point d’injection.
Comparer la réponse HTTP et le DOM final
Dans une application traditionnelle, le HTML de la réponse et le DOM final peuvent être proches. Dans une SPA, ils peuvent être très différents : le serveur renvoie parfois un simple conteneur, puis le JavaScript construit toute l’interface à partir d’API.
L’auditeur doit donc examiner à la fois la réponse brute et le DOM après exécution. Une donnée absente du HTML initial peut apparaître ensuite ; une valeur inoffensive dans la réponse peut aussi être relue puis injectée dans un sink dangereux.
Identifier précisément le contexte
Le marqueur peut apparaître dans :
<p>XSS-HACKAGORA-84721</p>ou :
<input value="XSS-HACKAGORA-84721">ou encore :
const name = 'XSS-HACKAGORA-84721';Ces trois positions demandent des analyses différentes. La construction d’un payload ne doit commencer qu’une fois le contexte compris.
Observer les transformations
L’auditeur teste ensuite le comportement de caractères ayant une signification dans le contexte identifié, par exemple <, >, « , ‘, ` `, & ou /`.
L’objectif n’est pas immédiatement de contourner un filtre, mais de déterminer ce que fait l’application. Le caractère < devient-il < ? Les guillemets sont-ils encodés ? Une valeur est-elle décodée deux fois ? Un sanitizer supprime-t-il l’élément ou seulement certains attributs ?
Ce travail révèle la protection réellement appliquée et permet souvent de distinguer un encodage correct d’une blocklist fragile.
Construire une preuve minimale adaptée au contexte
Une fois la structure comprise, la preuve de concept doit être aussi simple que possible. Pour un contexte HTML, un élément contenant un gestionnaire d’évènement peut être suffisant. Dans un attribut, il faut d’abord déterminer s’il est possible de sortir du délimiteur. Dans du JavaScript, la syntaxe exacte de la chaîne doit être analysée.
Une preuve minimale facilite la remédiation : elle montre clairement quelle frontière syntaxique a été franchie sans masquer le problème derrière un payload complexe.
Comment prévenir les vulnérabilités XSS ?
Il n’existe pas une protection unique applicable à toutes les situations. La stratégie la plus robuste consiste à maintenir une séparation stricte entre données et code, puis à choisir la protection en fonction du contexte de rendu.
Encoder au moment de la sortie et selon le contexte
Lorsque le besoin consiste à afficher du texte, l’encodage contextuel constitue l’une des protections principales. Une valeur destinée au corps HTML ne se traite pas comme une valeur d’attribut, une URL ou une chaîne JavaScript.
L’encodage doit être réalisé au plus près du sink. Encoder une donnée dès son entrée dans l’application est fragile : cela lie la valeur à un contexte particulier, peut provoquer un double encodage et ne protège pas les usages futurs dans d’autres syntaxes.
Les moteurs de templates modernes fournissent souvent un échappement automatique. Il est préférable de s’appuyer sur ces mécanismes plutôt que de recréer manuellement les transformations.
Privilégier les safe sinks
Le choix de l’API peut supprimer une grande partie du risque. Lorsqu’une chaîne doit simplement être affichée, textContent est préférable à innerHTML :
output.textContent = userInput;Au-delà de cet exemple, l’objectif consiste à utiliser des APIs qui manipulent des valeurs structurées plutôt que des fragments de code ou de markup. createElement(), l’affectation de propriétés sûres et la construction explicite de nœuds DOM sont souvent préférables à la concaténation de chaînes HTML.
Sanitiser lorsque du HTML doit réellement être accepté
Certaines fonctionnalités ont besoin de conserver du HTML : CMS, forums, éditeurs riches ou contenus Markdown convertis en HTML. Dans ce cas, un simple encodage détruirait la fonctionnalité.
Une bibliothèque de sanitisation spécialisée et maintenue, telle que DOMPurify pour les usages compatibles, est préférable à un filtre maison. La configuration doit être adaptée aux éléments et attributs réellement nécessaires.
La sécurité du pipeline ne s’arrête pas à l’appel au sanitizer. Le résultat ne doit pas être modifié ensuite avec des fragments non fiables ou injecté dans un contexte que la bibliothèque n’avait pas vocation à protéger.
Valider les entrées lorsque le format est connu
La validation réduit la surface d’attaque lorsque la donnée attendue possède un format clair. Un identifiant numérique peut être limité aux chiffres ; une date, une couleur ou une valeur d’énumération peuvent faire l’objet d’une allowlist stricte.
Cette mesure complète les protections de sortie mais ne les remplace pas. Un champ texte libre ne peut pas être rendu sûr en supprimant simplement quelques séquences considérées comme suspectes.
Éviter les blocklists de payloads
Une logique du type :
input.replace('<script>', '')est fondamentalement insuffisante. Les navigateurs disposent de nombreux mécanismes permettant d’obtenir un comportement actif sans utiliser cette chaîne exacte.
La bonne stratégie ne consiste pas à reconnaître toutes les attaques imaginables. Elle consiste à empêcher une donnée non fiable d’être interprétée comme du code dans le contexte où elle est utilisée.
Conserver les protections automatiques des frameworks
Les mécanismes d’échappement des frameworks et moteurs de templates doivent rester activés par défaut. Les APIs qui rendent du HTML brut ou marquent une valeur comme sûre doivent être rares, clairement identifiées et revues comme des frontières de sécurité.
Lorsqu’un composant reçoit du HTML contrôlé, la provenance de la donnée et la sanitisation doivent être explicites dans le code. Cette discipline facilite également les audits et réduit les contournements involontaires.
Content Security Policy comme défense en profondeur
CSP permet de restreindre les sources de scripts et les conditions d’exécution. Une politique moderne peut s’appuyer sur des nonces ou des hashes :
Content-Security-Policy:
  default-src 'self';
  script-src 'nonce-RANDOM_VALUE';
Des politiques plus avancées peuvent utiliser strict-dynamic lorsqu’il est approprié à l’architecture. L’objectif est de réduire l’exécution de scripts qui n’ont pas été explicitement autorisés.
CSP ne doit toutefois pas être considérée comme une correction de la XSS. Une politique permissive, une source autorisée exploitable ou une évolution de configuration peut rétablir l’exploitation. La vulnérabilité doit être corrigée au niveau du flux de données et du sink.
Trusted Types pour réduire les DOM XSS
Trusted Types apporte une protection architecturale contre l’utilisation accidentelle de chaînes arbitraires dans certains sinks DOM sensibles.
Une politique CSP peut notamment demander l’utilisation de Trusted Types sur les sinks concernés :
Content-Security-Policy: require-trusted-types-for 'script';Sur les navigateurs compatibles, le code doit alors fournir des objets Trusted Types plutôt que des chaînes ordinaires à certaines APIs. L’application peut centraliser la création de contenu HTML dans des politiques explicitement auditées, par exemple en passant les données par un sanitizer avant de produire un TrustedHTML.
Trusted Types ne rend pas une fonction de transformation correcte par magie. Une politique qui déclare sûr un contenu dangereux reste vulnérable. Son intérêt est de réduire le nombre d’endroits capables d’alimenter directement des sinks sensibles et de rendre ces frontières plus visibles dans le code.
HttpOnly et réduction de l’impact
L’attribut HttpOnly empêche JavaScript de lire directement la valeur d’un cookie concerné via document.cookie. Il limite donc certains scénarios de vol de session et devrait être utilisé pour les cookies d’authentification lorsque le fonctionnement le permet.
Il ne corrige cependant pas la XSS. Le script injecté peut toujours agir dans le navigateur authentifié et envoyer des requêtes pour lesquelles le cookie est automatiquement applicable.
HttpOnly doit donc être considéré comme une mesure de réduction d’impact, pas comme une défense primaire contre l’injection.
SameSite et périmètre réel de la protection
SameSite contrôle principalement les circonstances dans lesquelles un cookie est envoyé dans des requêtes initiées depuis d’autres sites. Il joue donc un rôle important contre plusieurs scénarios CSRF.
Une XSS s’exécute directement dans l’origine légitime ; l’intérêt de SameSite est alors beaucoup plus limité. L’attribut reste utile dans une stratégie globale de session, mais ne doit pas être présenté comme une protection directe contre les XSS.
Isoler les interfaces et origines sensibles
L’architecture peut également réduire l’impact. Une interface d’administration particulièrement sensible n’a pas toujours intérêt à partager la même origine qu’une zone permettant de rendre du contenu riche contrôlé par des utilisateurs.
Une séparation par origine peut limiter les interactions permises par la Same-Origin Policy et réduire la portée d’une compromission. Cette mesure ne remplace pas la correction des injections, mais elle constitue une défense en profondeur utile dans certains modèles de risque.
Maintenir les bibliothèques de rendu et de sanitisation
Les frameworks, parseurs Markdown, éditeurs WYSIWYG, sanitizers et composants manipulant du HTML font partie de la surface de sécurité. Ils doivent être inventoriés et maintenus à jour.
Une application peut utiliser correctement une bibliothèque tout en restant exposée si la version comporte un contournement connu ou si la valeur est ensuite modifiée dans un contexte non couvert par le modèle de sécurité de la bibliothèque.
Conclusion
Les failles XSS restent importantes parce qu’elles exploitent un élément central de la relation de confiance entre l’utilisateur et une application : son navigateur.
Leur compréhension ne doit pas se limiter à l’injection d’une balise <script> ou au vol de document.cookie. Une XSS moderne se comprend avant tout comme un problème de flux de données et de contexte d’interprétation. Une valeur contrôlable entre dans le système, traverse éventuellement plusieurs composants, puis atteint un point où le navigateur peut l’interpréter comme du contenu actif.
Cette approche explique pourquoi l’encodage doit dépendre du contexte, pourquoi les safe sinks sont préférables aux APIs interprétant du HTML, pourquoi la sanitisation n’est nécessaire que lorsque du contenu riche doit réellement être conservé, et pourquoi les protections automatiques des frameworks ne doivent pas être volontairement désactivées sans contrôle supplémentaire.
Du côté du pentest, la même logique s’applique en sens inverse. Une méthodologie efficace commence par identifier les données contrôlables et leurs restitutions, puis analyse les transformations et les sinks avant de construire une preuve adaptée. Cette méthode est particulièrement importante pour les DOM XSS, les injections persistantes dans des interfaces internes et les applications JavaScript complexes.
Enfin, la sévérité doit toujours être replacée dans le contexte fonctionnel : qui déclenche la charge, quelles données sont accessibles, quelles actions peuvent être réalisées et quel modèle de session est utilisé. C’est cette combinaison entre compréhension du navigateur, analyse des flux et évaluation des privilèges qui permet à la fois de détecter correctement les XSS et de les prévenir durablement.


